Theme Preview Rss
顯示具有 SPSS 標籤的文章。 顯示所有文章

1230 筆記:研究設計

第三章 研究設計
→題目找到,也找到自變項依變項,就可以開始做了。

準實驗設計
樣本通常是隨機取樣,無法立意(任意)取樣的。

實驗設計通常要具備
  • 自變項(男女、四五六年級)
  • 依變項(實驗的結果)
  • 控制變項(控制住某一個元素)、中介變項
選擇的變項類型,當然越多就越複雜
  • 單因子設計(只有陽光)
  • 雙因子設計(同時有陽光、水)
  • 多因子設計(同時有陽光、空氣、水)

實驗組與對照組的設計表格,特色如下:
  1. 可以比較整個實驗組跟對照組
  2. 可以比較實驗組與對照組的男生與男生、女生與女生
圖示:實驗組與對照組設計

控制變項:把實驗環境內,會干擾實驗的變項都排除。找兩個非研究背景的老師教導。
中介變項:若自變項對依變項有影響效果,而此效果是透過另一變項達到影響,則此變項即為中介變項,通常用以解釋自變項是經由什麼歷程影響了依變項。來自台大工商心理學組

研究架構 ←→ 研究流程/步驟

一 研究架構:指自變項、依變項、中介變項、……。在於分析整個實驗過程的訊續等。

圖示:研究架構,指出自變項、依變項等,圖為簡圖。
二 研究樣本:等組(機率小)、不等組(機率大)
圖示:研究樣本,此為細部不等組,但總體為等組之設計。
三 研究步驟:就像流程圖一樣。使用工具,是信、效度哪一種。
圖示:研究步驟流程簡圖。
四 分析工具:使用SPSS、單因子變異數、T檢驗……有的沒的。

1117 實做

課堂實做
態度量表,就像是期末教學量表一樣。
  1. 請模擬態度量表有無改變,製作出一個30人的問卷量表,最低分1最高分5。
    算出三次(甲乙丙班級)的前測成績。=RAND()*4+1
  2. 貼到SPSS內
  3. 敘述統計→描述性統計
  4. 比較平均數法→單因子變異數分析
    (第二次)勾選「選項」→「描述性統計量」
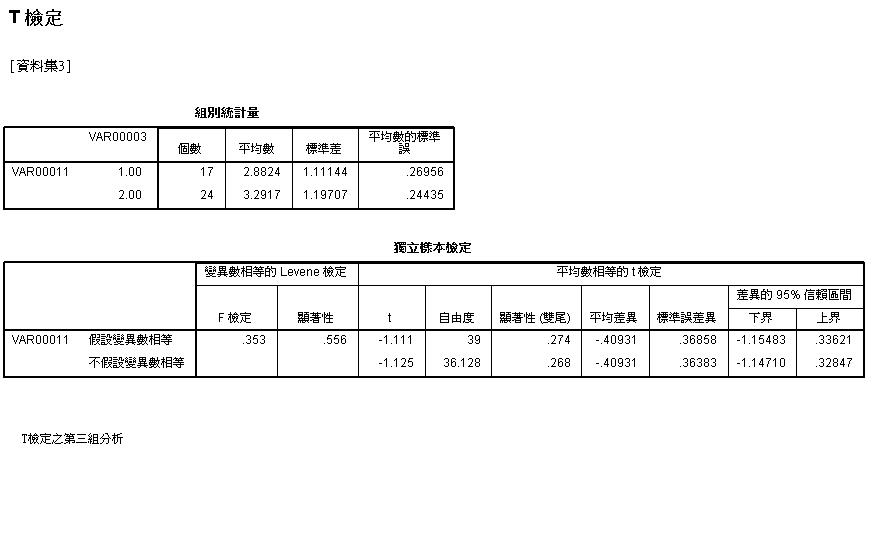
  5. 比較平均法→獨立樣本T檢定
    (第二次)點選「定義組別」→「輸入1、2


  • 獨立樣本檢定「t」的那一欄位其實是不需要的
  • 雙尾(平均分配在兩側2.5%區域的)顯著性
  • 單尾(偏某一側變成5%區域的)顯著性
顯著性:發生錯誤的機率有多大,指的是α發生的機率。
  • 準確率95% → 0.050 錯誤率,以 * 代替
  • 準確率91% → 0.010 錯誤率,以 ** 代替
  • 準確率100% → 0.000 錯誤率,以 *** 代替
回家作業
  1. 改變第三組資料
  2. 用ANOVA找出所有顯著性(<0.050)

  3. 用T檢定找出第三組與第一組、第二組的差別
  4. 比較T檢定報表之不同


1110 課堂實做

圖示:已知樣本與已知母群標準差推估母群平均數

→範圍越,區間估計值準確度越

  1. 打開excel文件
  2. A1至A30寫輸入1,A31到A60輸入2,A61到A90輸入3
  3. 在B1到B90製作出範圍在30-60的亂數90組
  4. 選取複製、在C以及D內 貼上『值』,並注意儲存格式不能有小數點
  5. 將B刪除,複製A到C的所有數值
  6. 打開SPSS,將數值貼上
  7. 進行「單因子T檢定」分析
圖示:T test
圖示:T test
圖示:T test
  1. 步驟如上1到4
  2. 修改B的數值,改為取35到60的亂數90組
  3. 選取複製、在E內 貼上『值』,並注意儲存格式不能有小數點
  4. 將B刪除,複製A到D的所有數值
  5. 打開SPSS,將數值貼上
  6. 進行「單因子變異數」分析
圖示:變異數
圖示:變異數
圖示:變異數

1103 小筆記:常態累積機率表、SPSS 區間估計

常態累積機率表
+/-誤差3%,百分點在0.9750

使用SPSS製作『常態累積機率』檢驗 單因子變異數分析
→輸入三十個數字兩行

→把兩行都圈選起來
→選擇分析
→選擇比較平均數法
→選擇單一樣本T檢定

→選擇兩行數字
→按下確定


差異的95%信賴區間的『上下界』是什麼意思:
範本平均數在這兩個值(上界x1.96、下界x0.3)之間

1020 非常態分配之曲線

非常態分配:
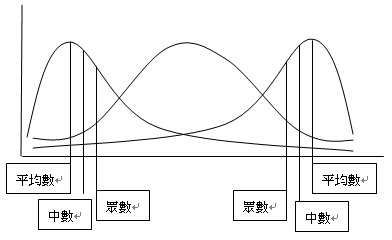
A’以及A是同等面積的,尾巴往右是正偏態,尾巴往左是負偏態。
正:當人當很多課的是正偏態。
負:美術等勞作課程是負偏態。
圖示:非常態分配之常態化

常態:
中數眾數平均數都落在同一點上面。平均數=中數=眾數

非常態(偏態):
正偏態→平均數、眾數、中數往左邊移動。移動快慢:平均數>中數>眾數
負偏態→平均數、眾數、中數往右邊移動。移動快慢:眾數>中數>平均數
圖示:正負偏態

1006 筆記:標準差 stander deviation

簡稱SD,是一個母群體的概念。
SD 是一個非常有用的指標,MEAN 只是告訴你一個結果,無法像SD 可以判別狀態(分散或集中)。

母群 population(人口):母群是浮動的。母群或許為(N已知and固定)or(N未知and不固定)通常在母群內找抽樣sampling(取樣),取出來的叫做Sample(樣本),以樣本進行計算,描述這個計算的結果,就叫做敘述統計。

上圖:推論 與 敘述 之差別

一般來說,母群與樣本,是等比的增加或減少,而非固定。
調查:如果是取樣一千人,則這一千個樣本數,代表著總數約一千到一千五百萬的母群。

老師提醒:最少的樣本量是30,低於30,則樣本數不足,不足以取信於人。樣本數大於30,則會趨近於母群。

上圖:標準差計算概念

0929 練習


<<練習用SPSS>>
1. 先使用excel在A格內製作40個亂數(最低60最高85)
2. 再將40個數字 ” 選擇性貼上(選值)" 到旁邊的B格
3. 將B表格的數字貼在SPSS軟體內
選擇分析→敘述統計→描述性統計量→點選”選項”(選擇自己要的項目)→the end
選擇分析→敘述統計→次數分配表→點選”選項”(選擇自己要的項目)→the end

─備註─
亂數=RAND()*A+B) ← 取A到B之間的數值
總和=SUN()
中數=MEDIAN()
算術平均數=AVERAGE()
眾數=MODE() 在excel內不是整數無法找出眾數,但SPSS可以……